- SpaceXAI가 2026년 9월 18일 Grok Voice Transcribe 2.0을 공개했다.
- 기존 연동은 코드를 바꾸지 않고 정확도 개선을 받을 수 있으며, 배치와 실시간 스트리밍을 모두 지원한다.
- 한국 개발자에게 중요한 변화는 낮은 단가보다 화자 분리·단어별 타임스탬프·키워드 편향을 한 API에서 제공한다는 점이다.
- 다만 한국어 공개 평가와 데이터 보관 조건은 별도로 확인해야 하므로, 운영 전 자체 음성으로 비교해야 한다.
결론부터 말하면, 회의록·콜센터·음성 명령을 새로 만드는 팀은 시험할 가치가 크지만 기존 STT를 즉시 교체할 근거는 아직 부족하다.
업데이트 기준일은 2026년 9월 18일이다. 이번 출시는 단순한 음성 인식 모델 교체가 아니라, 음성을 다음 에이전트가 안전하게 소비할 수 있는 구조화된 입력으로 바꾸려는 업데이트로 보는 편이 정확하다.
무엇이 바뀌었나
SpaceXAI는 Grok Voice Transcribe 2.0을 공개하며 자체 실제 환경 평가에서 1.0보다 오류가 절반 수준이고 가격은 같다고 밝혔다.[1] 회사 설명에 따르면 새 모델은 잡음, 전화 음질, 억양, 여러 화자, 말로 읽은 전화번호와 이메일 주소처럼 실서비스에서 자주 깨지는 입력을 중심으로 학습·후처리됐다.[1]
다국어 짧은 문장 자체 평가에서는 단어 오류율이 20.6%에서 6.8%로 내려갔다. 다만 이 수치는 SpaceXAI 내부 데이터셋 결과이므로 한국어 서비스 품질을 그대로 보장하는 독립 검증치로 해석하면 안 된다.[1]
Artificial Analysis는 별도 스트리밍 평가에서 최종 전사 단어 오류율 2.7%, 발화 종료 후 0.49초를 보고했고, 당시 비교한 33개 모델 가운데 정확도 1위로 정리했다.[3] Vals도 2026년 9월 18일 출시, 스트리밍 지원, 비공개 가중치 모델로 기록했지만 평가 지표와 환경이 다르므로 숫자를 직접 섞어 비교해서는 안 된다.[4]
| 구분 | 이전 1.0 | 2.0에서 달라진 점 | 도입 판단 |
|---|---|---|---|
| 연동 | 기존 STT API | 같은 API에서 기본 모델 전환 | 회귀 테스트 후 핀 고정 |
| 출력 | 전사 중심 | 단어별 시간·신뢰도, 화자 구분 | 후속 자동화에 유리 |
| 실시간 | 스트리밍 지원 | 스마트 턴 감지와 부분 결과 | 음성 에이전트에 적합 |
| 운영 | 단일·일반 음성 | 최대 8채널, 키워드 최대 100개 | 콜센터·전문 용어에 유리 |
어떻게 작동하나
배치 요청
배치 요청은 음성 파일 또는 URL을 REST API로 보내고, 모델이 전체 텍스트와 언어, 길이, 단어별 시작·종료 시각을 반환하는 구조다. 공식 문서는 WAV·MP3·OGG·Opus·FLAC·AAC·MP4·M4A·MKV를 포함한 컨테이너 형식과 최대 500MB 파일을 안내한다.[2]
실시간 스트리밍
실시간 모드는 WebSocket으로 PCM·µ-law·A-law·Opus 프레임을 전송한다. 중간 결과를 켜면 말하는 동안 부분 전사를 받고, 끝점 감지나 스마트 턴 판단으로 다음 에이전트 호출 시점을 결정할 수 있다.[2]
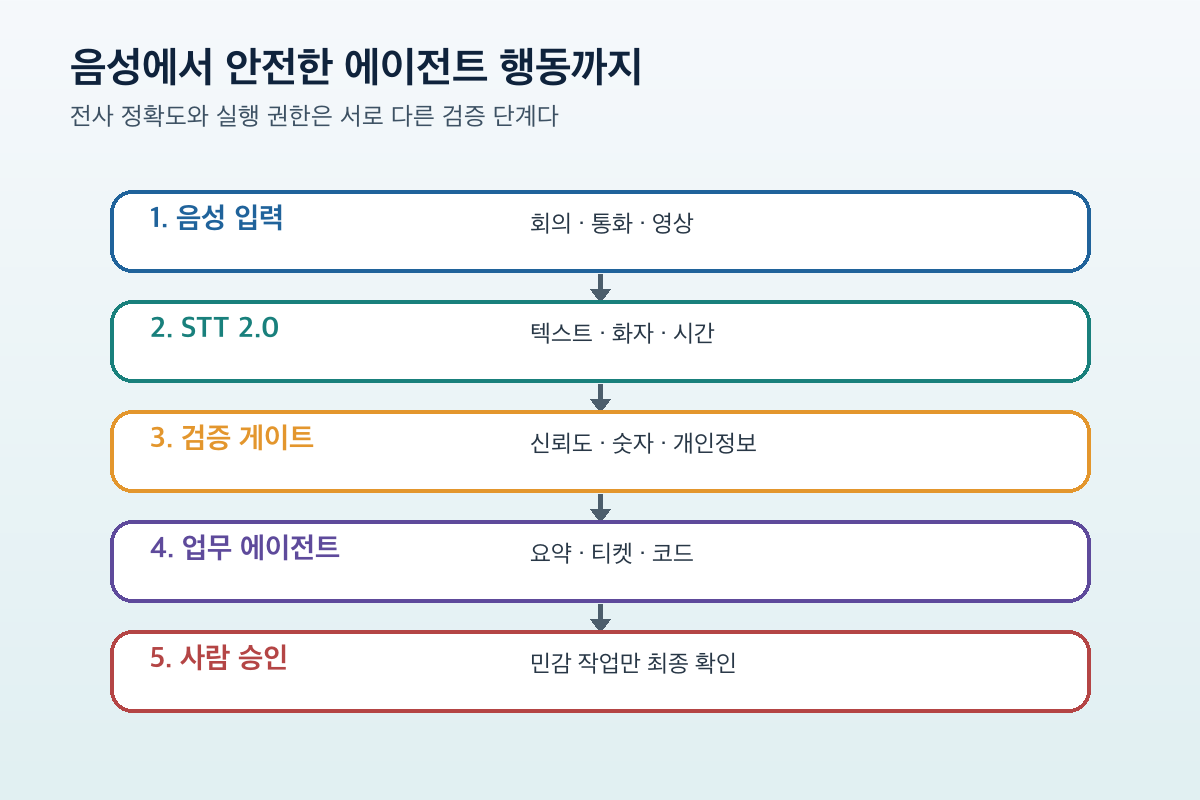
핵심은 STT가 최종 화면이 아니라 파이프라인의 첫 단계라는 점이다. 음성 → 전사·화자·신뢰도 → 검증 규칙 → LLM/업무 도구 → 사람 승인 순서로 설계하면 낮은 신뢰도의 고유명사나 숫자를 다시 묻고, 확정된 문장만 티켓·코드·CRM으로 보낼 수 있다.
Gemini 3.8 Live 음성 에이전트 구조에서 설명한 비동기 도구 실행과 결합할 때도 전사 결과를 곧바로 실행 명령으로 취급하지 말아야 한다. 음성 입력은 오인식뿐 아니라 주변 대화와 프롬프트 주입까지 포함할 수 있으므로 신뢰 경계가 필요하다.
이전 방식과 무엇이 다른가
기존 음성 자동화는 전사, 화자 분리, 타임스탬프, 턴 감지를 서로 다른 서비스나 후처리 코드로 조립하는 경우가 많았다. 2.0은 이 정보를 한 API 응답과 스트리밍 이벤트에서 제공해 연결 지점을 줄이는 방향이다.[1][2]
연결 지점이 줄면 지연과 유지보수 비용을 낮출 수 있지만 공급자 종속성은 커진다. 모델이 곧 기본값으로 바뀌고 1.0은 향후 폐기될 예정이므로, 재현성이 필요한 서비스는 모델 이름을 명시하고 자체 골든셋으로 변경 전후를 기록해야 한다.[1][2]
| 판단 항목 | 바로 시험할 팀 | 기다릴 팀 |
|---|---|---|
| 입력 환경 | 전화·회의·현장 소음이 많음 | 깨끗한 단일 화자 녹음만 처리 |
| 후속 작업 | 티켓·요약·코드 작업으로 연결 | 사람이 전사문만 읽음 |
| 규제·보안 | 외부 API 전송이 허용됨 | 망 분리·온프레미스가 필수 |
| 언어 품질 | 한국어 자체 평가셋이 있음 | 공개 벤치마크만 믿고 결정 |
한국 개발자와 크리에이터에게 중요한 이유
한국어가 공식 지원 언어 목록에 포함되고, 언어 코드를 지정하면 숫자·통화·단위 형식을 정규화할 수 있다.[2] 회의에서 나온 금액, 날짜, 전화번호를 후속 시스템이 읽기 쉬운 형태로 바꾸는 데 유용하지만, 한국식 주소·회사명·영문 혼용·제품명은 별도 검증이 필요하다.
크리에이터는 긴 영상의 자막 초안을 만들고 단어별 타임스탬프로 편집점을 잡을 수 있다. 개발팀은 Loom 같은 설명 영상을 이슈 초안으로 바꾸고, 사람이 승인한 요구사항만 Claude Code Projects 병렬 에이전트 운영 가이드 같은 코딩 워크플로에 넘길 수 있다.
초기 Hacker News 토론은 기능과 가격에는 관심을 보였지만 공개 평가가 실제 서비스 체감과 다를 수 있다는 반론도 나왔다.[5] 따라서 “1위” 문구보다 한국어 도메인 데이터에서 잘못 들은 숫자와 고유명사가 실제로 얼마나 줄었는지를 봐야 한다.
실전 적용: 재현 가능한 도입 실험
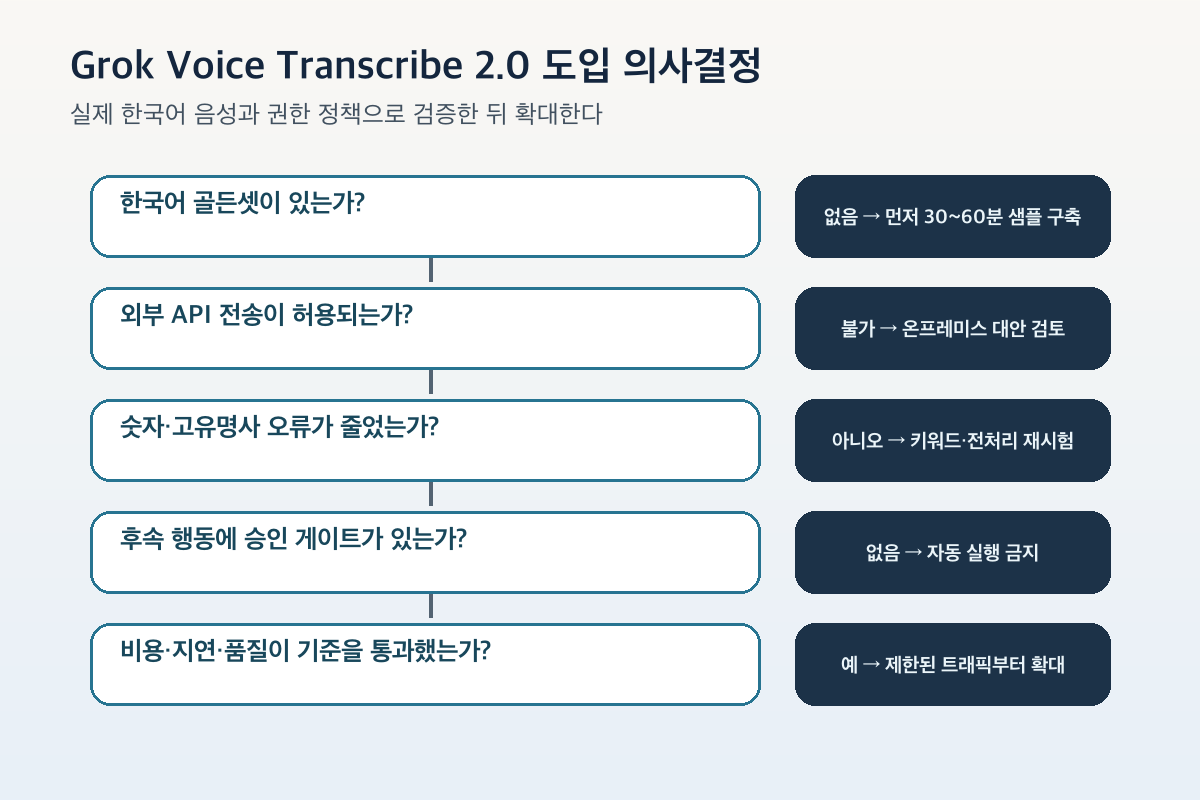
- 실제 사용 환경에서 30~60분 분량의 한국어 음성을 익명화해 준비한다.
- 깨끗한 회의, 잡음이 있는 통화, 영문 제품명이 섞인 문장을 각각 포함한다.
- 기존 모델과 2.0에 같은 파일을 넣고 단어 오류율, 숫자 오류, 화자 혼동, 처리 시간, 시간당 비용을 기록한다.
keyterm에 서비스명과 전문 용어를 넣은 경우와 넣지 않은 경우를 비교한다.- 신뢰도가 낮거나 금액·계정·배포 명령이 포함된 문장은 자동 실행하지 않고 사람 승인으로 보낸다.
공식 REST 요청에서는 model=grok-voice-transcribe-2.0, language=ko, format=true를 지정하고 파일 필드를 마지막에 둔다. 화자 분리가 필요하면 diarize=true, 전문 용어 보정에는 반복 가능한 keyterm 필드를 사용한다.[2]
가장 중요한 주의점은 전사 정확도가 높아져도 음성에서 추출한 명령의 권한이 자동으로 안전해지지는 않는다는 사실이다.
한계와 도입 체크리스트
- ☐ 한국어·사투리·영문 혼용 자체 평가셋에서 기존 모델과 비교했는가
- ☐ 숫자, 이메일, 주소, 제품명 오류를 별도 지표로 측정했는가
- ☐ 개인정보와 녹취 동의, 보관 기간, 처리 지역을 계약·정책에서 확인했는가
- ☐ API 키를 브라우저나 모바일 앱에 노출하지 않고 서버 프록시를 사용하는가
- ☐ 모델 이름을 고정하고 기본 모델 변경에 대비한 회귀 테스트가 있는가
- ☐ 낮은 신뢰도와 민감 작업에 사람 승인 단계를 두었는가
- ☐ 장애·429·503 응답에 재시도와 대체 경로가 있는가
공식 문서는 클라이언트 코드에 API 키를 노출하지 말고 백엔드 프록시를 사용하라고 명시한다. 또한 429에는 지수 백오프, 503에는 재시도를 권장한다.[2]
결론
Grok Voice Transcribe 2.0의 경쟁력은 화려한 데모보다 저렴한 전사와 화자·시간·키워드 정보를 한 파이프라인으로 묶은 데 있다. 회의록, 고객 통화, 영상 자막, 음성 명령을 에이전트 작업으로 연결하려는 한국 팀에는 실용적인 후보가 됐다.
하지만 공개된 한국어 독립 평가는 아직 충분하지 않고 모델 가중치도 비공개다.[4] 지금 할 일은 전면 교체가 아니라 실제 한국어 음성으로 작은 병렬 실험을 돌리고, 비용보다 오류가 후속 행동에 미치는 위험을 기준으로 채택 여부를 결정하는 것이다.