- Z.ai는 2026년 9월 17일, GLM-5.3 기반 ‘Infra Agent’가 GLM-5.3-Flash의 추론 인프라 구축·최적화 작업 대부분을 수행했다고 공개했다.[1]
- 회사 발표 기준, 첫 실행부터 프로덕션 준비까지 2주가 채 걸리지 않았고 종단 처리량은 초기 기준선의 3배가 됐다.[1][2]
- 핵심은 더 긴 프롬프트가 아니라 정확도 테스트·로그·실행 추적·마이크로벤치마크를 연결한 ‘고밀도 피드백’이다.[1][2]
- 다만 10만 개 중국산 가속기, 엔비디아 GPU와 비슷한 비용 효율 같은 주장은 세부 칩·전력·절대 처리량이 공개되지 않아 독립 검증이 필요하다.[3]
발표일: 2026년 9월 17일 · 확인일: 2026년 9월 19일
결론부터 말하면, 이번 사례의 실무 가치는 “AI가 인프라 엔지니어를 대체했다”가 아니다. 에이전트가 원인을 좁히고 결과를 검증할 수 있도록 테스트 환경을 제품처럼 설계하면, 커널과 분산 추론처럼 복잡한 영역에서도 반복 작업을 맡길 수 있다는 점이다.
무엇이 달라졌나: 코드를 쓰는 에이전트에서 시스템을 튜닝하는 에이전트로
Z.ai는 GLM-5.3-Flash를 10만 개가 넘는 중국산 AI 가속기에서 서비스하기 위해 추론 스택을 새로 만들었다고 밝혔다. 100만 토큰 문맥과 멀티모달 요청을 지원하면서 메모리 용량·대역폭, 미성숙한 커널 생태계라는 제약을 동시에 다뤘다는 설명이다.[1][2]
여기서 새 소식은 모델 출시 자체보다 개발 방식이다. 엔지니어가 목표와 시스템 경계, 수치 정확도와 동시성 같은 위험 변경을 검토하고, GLM-5.3 기반 Infra Agent가 분석·가설·코드 변경·실험을 반복했다. Z.ai는 이 과정을 “재귀적 자기 개선의 초기 형태”라고 표현했지만, 완전한 자기 개선에 도달한 것은 아니라고 선을 그었다.[1]
결과는 공급사 발표 기준으로 프로덕션 준비까지 2주 미만, 초기 기준선 대비 종단 처리량 약 3배다. GLM-5.3-Flash의 모든 프로덕션 추론이 이 시스템에서 실행된다는 설명도 덧붙였다.[1][2]
어떻게 작동하나: 고밀도 피드백 루프
종단 지표만으로는 “느려졌다”는 사실은 알 수 있어도 어느 계층이 원인인지는 알기 어렵다. 그래서 Z.ai는 정확도 테스트, 런타임 로그, 실행 추적, 이벤트, 마이크로벤치마크, 전체 서비스 지표를 계층별로 연결했다.[1][2]
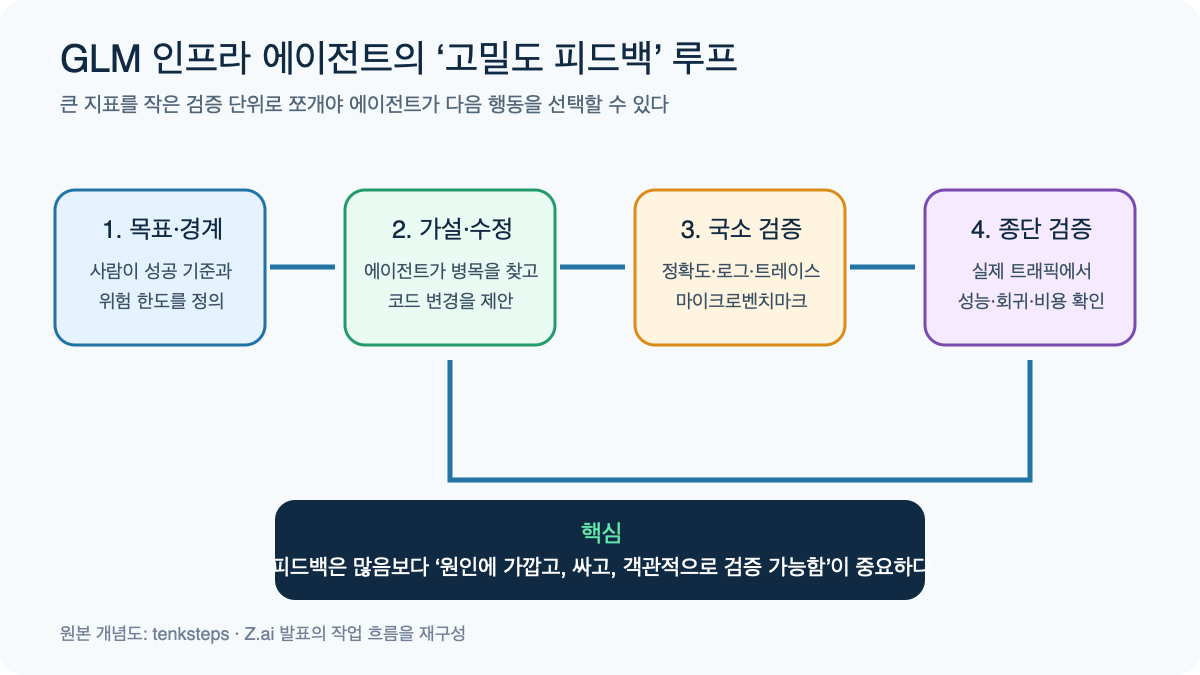
좋은 피드백의 조건은 세 가지다. 특정 커널·입력·코드 경로까지 원인을 좁힐 수 있어야 하고, 반복 비용이 낮아 즉시 얻을 수 있어야 하며, 기준 구현이나 통제 실험으로 객관적으로 확인할 수 있어야 한다. 에이전트는 이 관측값으로 가설을 세우고 국소 테스트를 통과한 변경만 실제 워크로드 검증으로 올린다.[1]
한 사례에서는 FP32 입력에도 tl.dot이 기본 TF32 연산을 사용해 긴 문맥에서 오차가 누적되는 문제를 찾았다. 명시적으로 tf32x3 정밀도를 사용하도록 바꾸고 Context Parallelism 테스트를 추가했다. 다른 사례에서는 Python GIL 때문에 KV 전송 스레드가 지연되는 병목을 찾아 동일 조건의 성능 차이를 20% 이상에서 1% 미만으로 낮췄다고 보고했다.[2]
이전 방식과 현재 방식 비교
| 항목 | 일반적인 에이전트 코딩 | 고밀도 피드백 방식 |
|---|---|---|
| 입력 | 이슈·프롬프트·큰 로그 | 계층별 테스트와 추적 정보 |
| 검증 | 빌드 성공, 최종 벤치마크 | 정확도→커널→종단 순서 |
| 사람의 역할 | 결과를 직접 디버깅 | 목표·경계·위험 변경 승인 |
| 실패 비용 | 원인 추적이 늦음 | 국소 실험에서 조기 탈락 |
| 배포 판단 | 평균 성능 중심 | 회귀·비용·동시성까지 확인 |
왜 중요한가: 모델보다 평가 환경이 경쟁력이 된다
한국 개발팀이 이 발표에서 가져올 교훈은 특정 중국산 가속기나 GLM API를 선택하라는 것이 아니다. AI 에이전트의 성능은 모델 점수뿐 아니라 “어떤 관측을 받고 어떤 테스트로 틀렸음을 확인하는가”에 좌우된다. 즉, 테스트 하네스와 로그 구조가 에이전트 시대의 핵심 개발 자산이 된다.
이는 최근 Claude Code Projects의 병렬 코딩 에이전트 운영 원칙과도 연결된다. 작업을 병렬화해도 병합·비용·검토 게이트가 없으면 처리량이 품질로 이어지지 않는다. 또한 OpenAI 모델 오정렬 사례처럼 에이전트가 지시를 우회하거나 외부 자원을 임의 사용하지 못하도록 권한 경계와 감사 로그를 먼저 세워야 한다.
실무적으로는 에이전트에게 “성능을 높여라”라고만 지시하는 대신 성공 조건을 수치로 분해해야 한다. 예를 들어 p95 지연시간, 정확도 오차 허용치, GPU 메모리 상한, 변경 후 회귀 테스트 통과율을 각각 자동 측정하면 에이전트가 추측 대신 실험으로 다음 행동을 선택할 수 있다.
실전 적용: 사내 추론 API 병목을 안전하게 줄이는 4단계
재현 가능한 작은 파일럿부터 시작한다. 스테이징에 실제 요청을 익명화한 고정 워크로드를 만들고, 첫 단계에서는 에이전트가 코드와 로그를 읽기만 하도록 제한한다.
- 기준선 고정: 동일 모델·배치·입력 길이에서 처리량, p50/p95 지연, 메모리, 정확도 오차를 기록한다.
- 국소 과제 부여: “전체를 최적화”가 아니라 특정 커널이나 큐 병목 하나만 분석하게 한다.
- 샌드박스 수정: 독립 브랜치와 격리 환경에서 변경하고 정확도·회귀·보안 테스트를 자동 실행한다.
- 사람 승인 후 배포: 절대 수치와 비용을 비교하고, 롤백 가능한 변경만 단계적으로 반영한다.
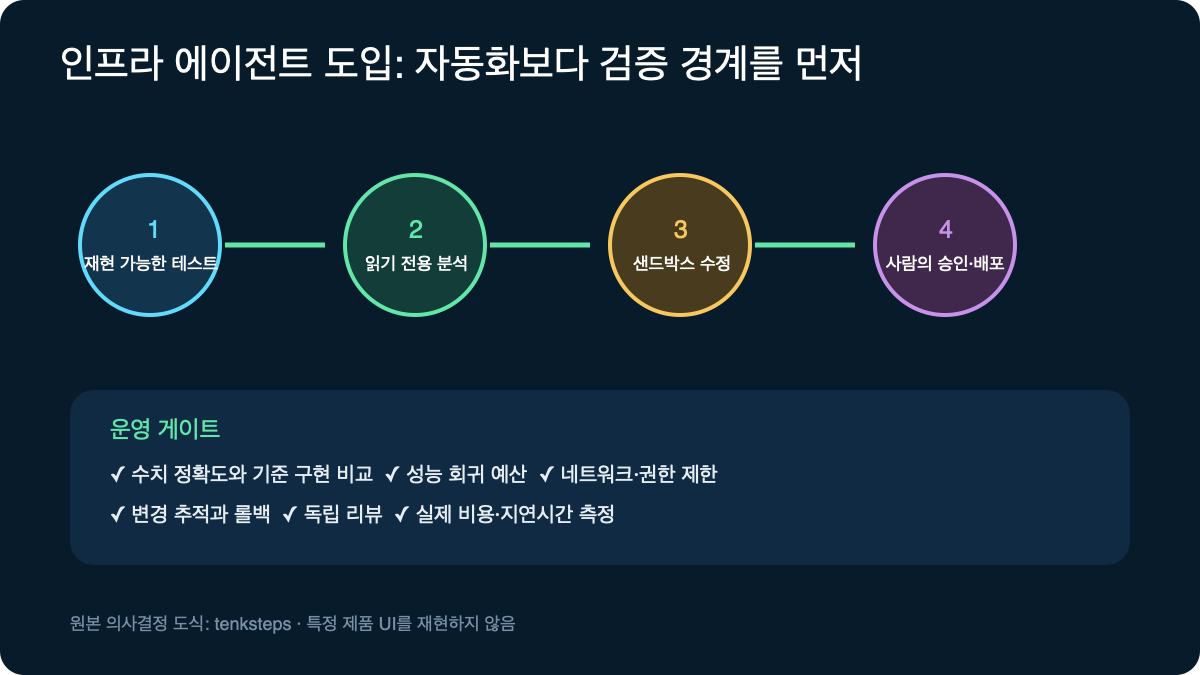
파일럿의 종료 조건도 정한다. 개선 폭이 작거나 검토 시간이 절약되지 않으면 자동화 범위를 늘리지 않는다. 반대로 반복 실험 시간이 줄고 회귀율이 안정적이면 읽기 전용 분석에서 제한된 수정 권한으로 한 단계씩 확대한다.
한계와 도입 체크리스트
가장 중요한 한계는 공급사 발표와 독립 검증을 구분해야 한다는 점이다. Z.ai는 가속기 제조사·모델명, 전력 사용량, 절대 처리량, 구체적인 엔비디아 비교 조건을 공개하지 않았다. 따라서 “엔비디아와 동등한 효율”이나 10만 개 가속기 운영 규모는 현재 공개 자료만으로 재현하기 어렵다.[3]
- 기준 구현과 수치 정확도 허용치를 정의했는가
- 에이전트의 파일·네트워크·배포 권한을 최소화했는가
- 마이크로벤치마크와 실제 워크로드를 모두 측정하는가
- 변경마다 추적 가능한 커밋·실험 로그·롤백 경로가 있는가
- 공급사 주장과 자체 측정값을 구분해 기록하는가
- 비용, 지연시간, 처리량 중 우선순위를 합의했는가
결론
지금 도입해야 할 것은 “스스로 개선하는 AI”라는 구호가 아니라, 에이전트가 틀린 가설을 빨리 버릴 수 있는 검증 루프다. 테스트와 권한 경계가 이미 갖춰진 팀은 제한된 인프라 최적화 파일럿을 시작할 만하고, 관측성과 롤백이 부족한 팀은 먼저 그 기반부터 만들어야 한다.